
GPT-6 Astra 3D 建模(三) 场景初探
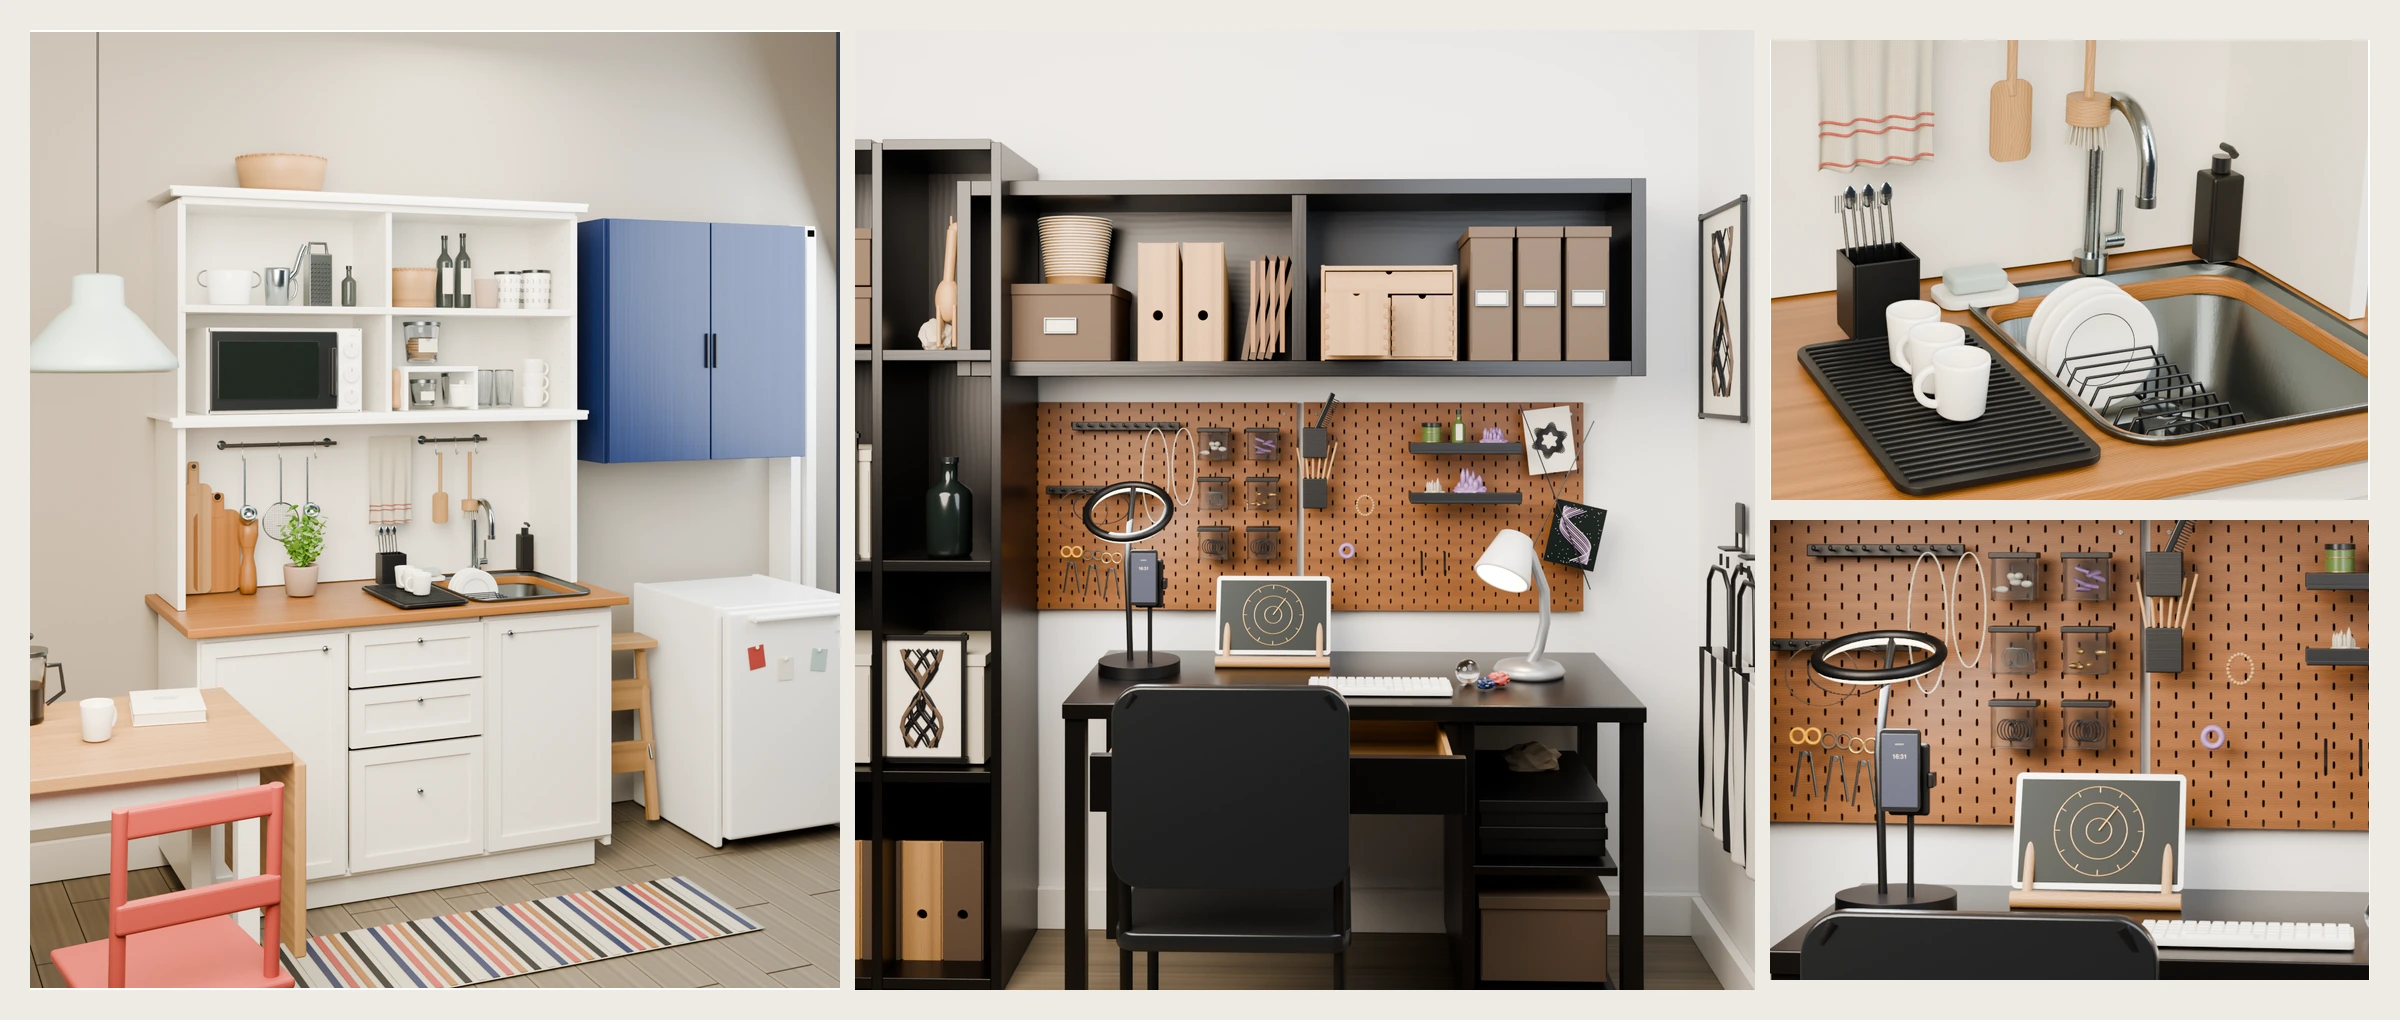
之前两篇 (GPT-6 Astra 3D 建模(一) 单物体初探、GPT-6 Astra 3D 建模(二) 细节补充)介绍了单物体生成。下一步很自然的扩展就是多物体场景。
输入仍然是稀疏图片(厨房两张图片、工作区单张图片)。
要求 GPT-6 Astra 创建完整场景,每个物体可以单独使用。照片没拍到的部分需要合理补全,柜门、抽屉和灯具等代表性结构保留交互能力。
厨房场景
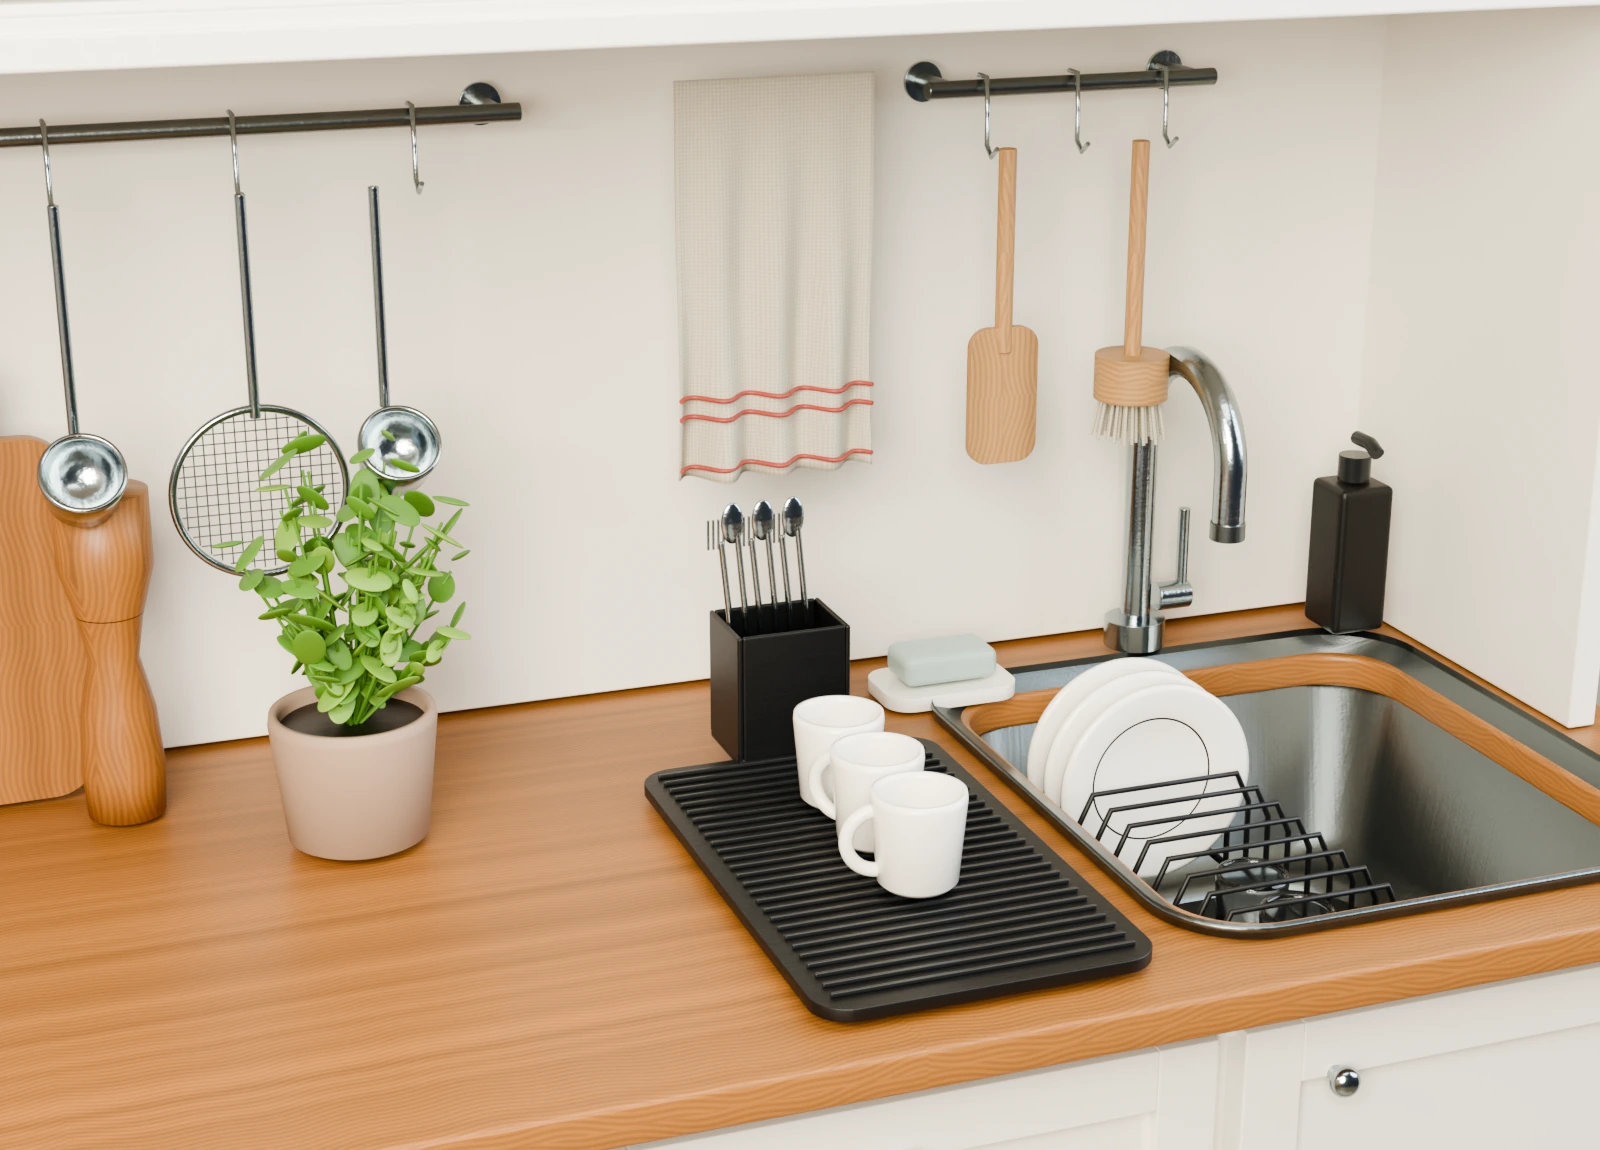
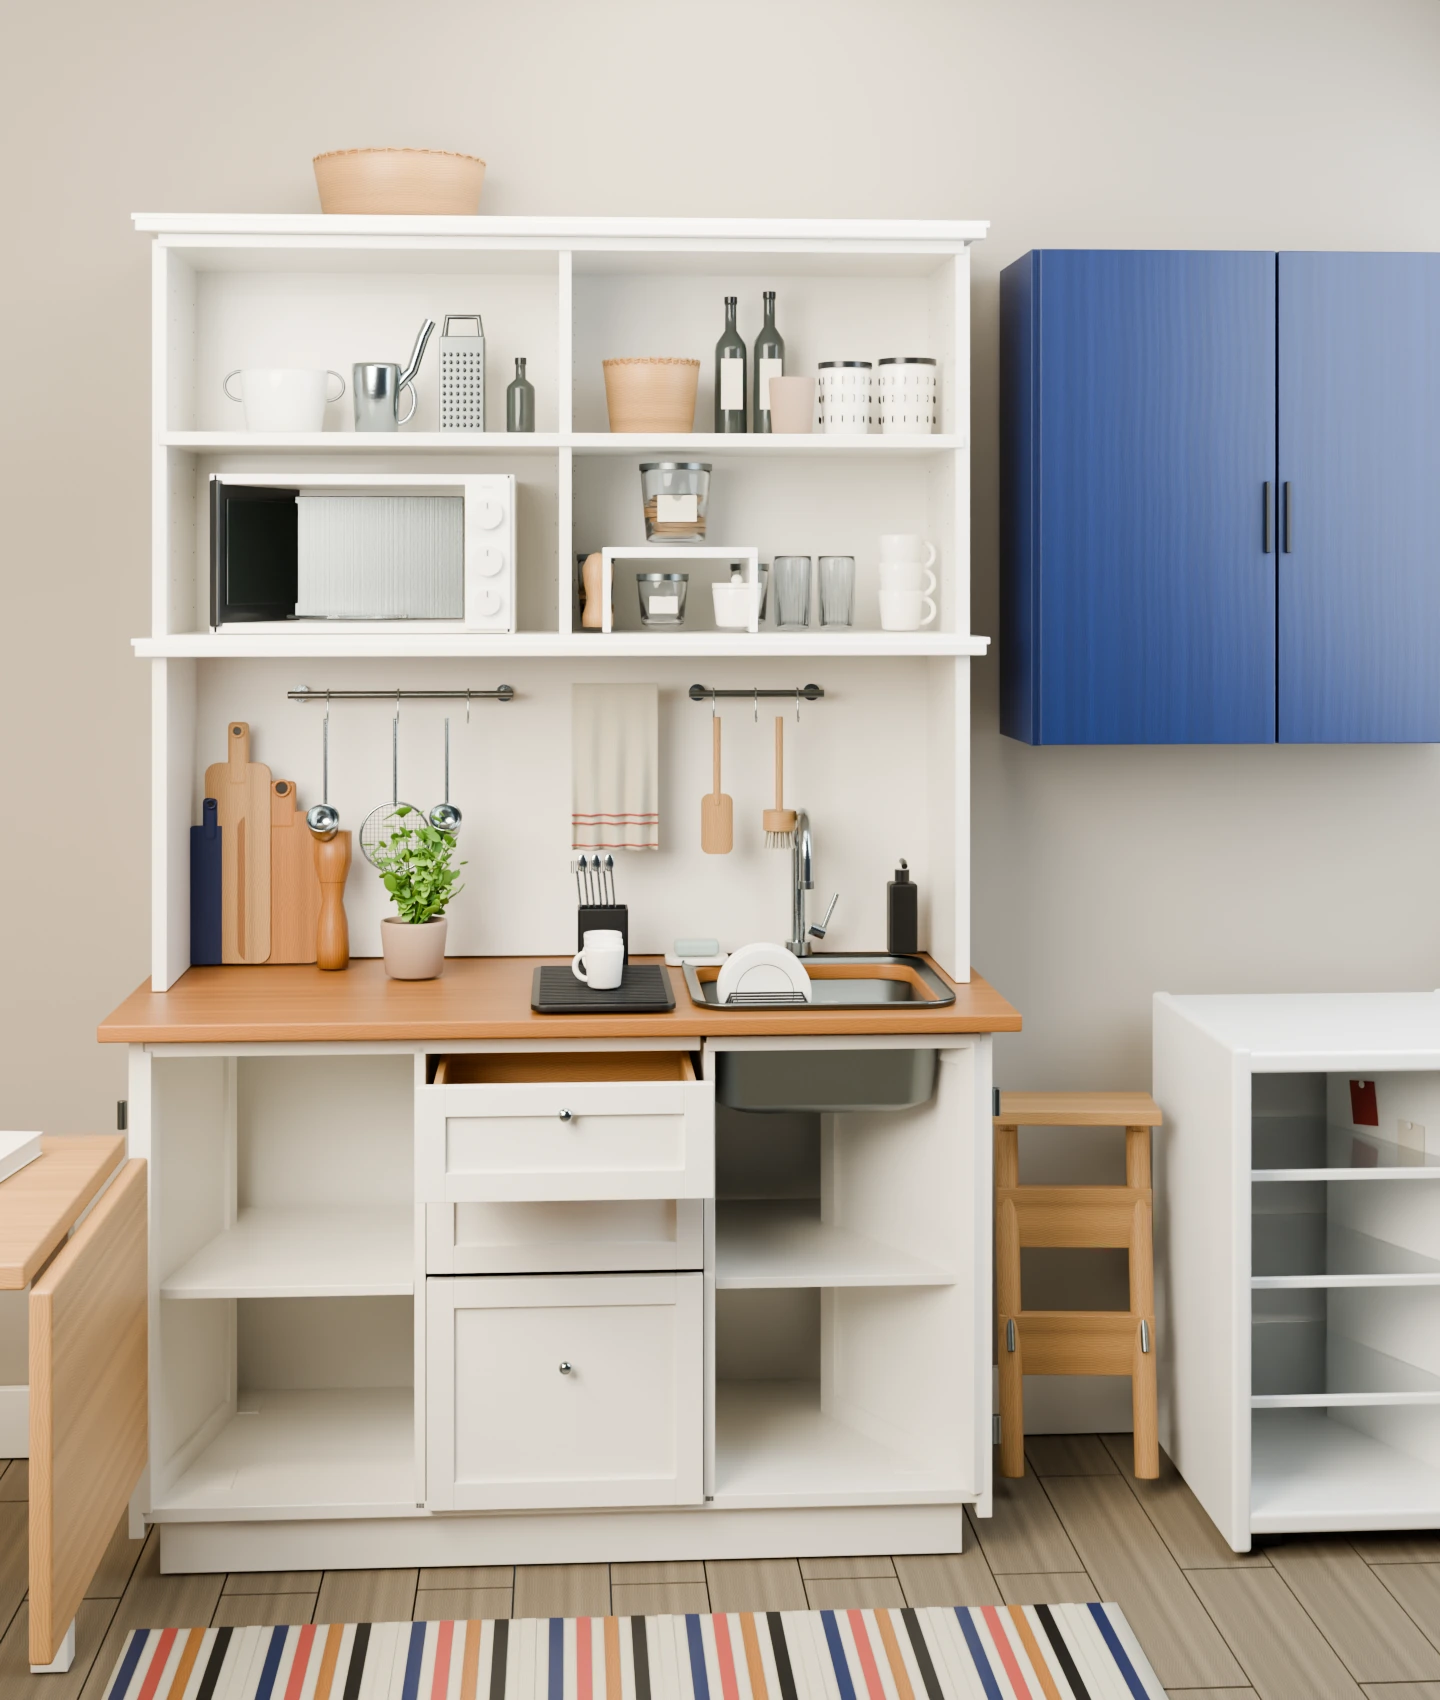
两张输入图片来自互联网检索,分别是平视和俯视视角,前者中可以看清白色主柜、开放层架和蓝色壁柜的比例;后者补充了台面、冰箱与踏凳的位置。
需要说明的是,两张图片并非严格同一场景的多视角图像,例如餐具在两张图中的摆放存在不同。
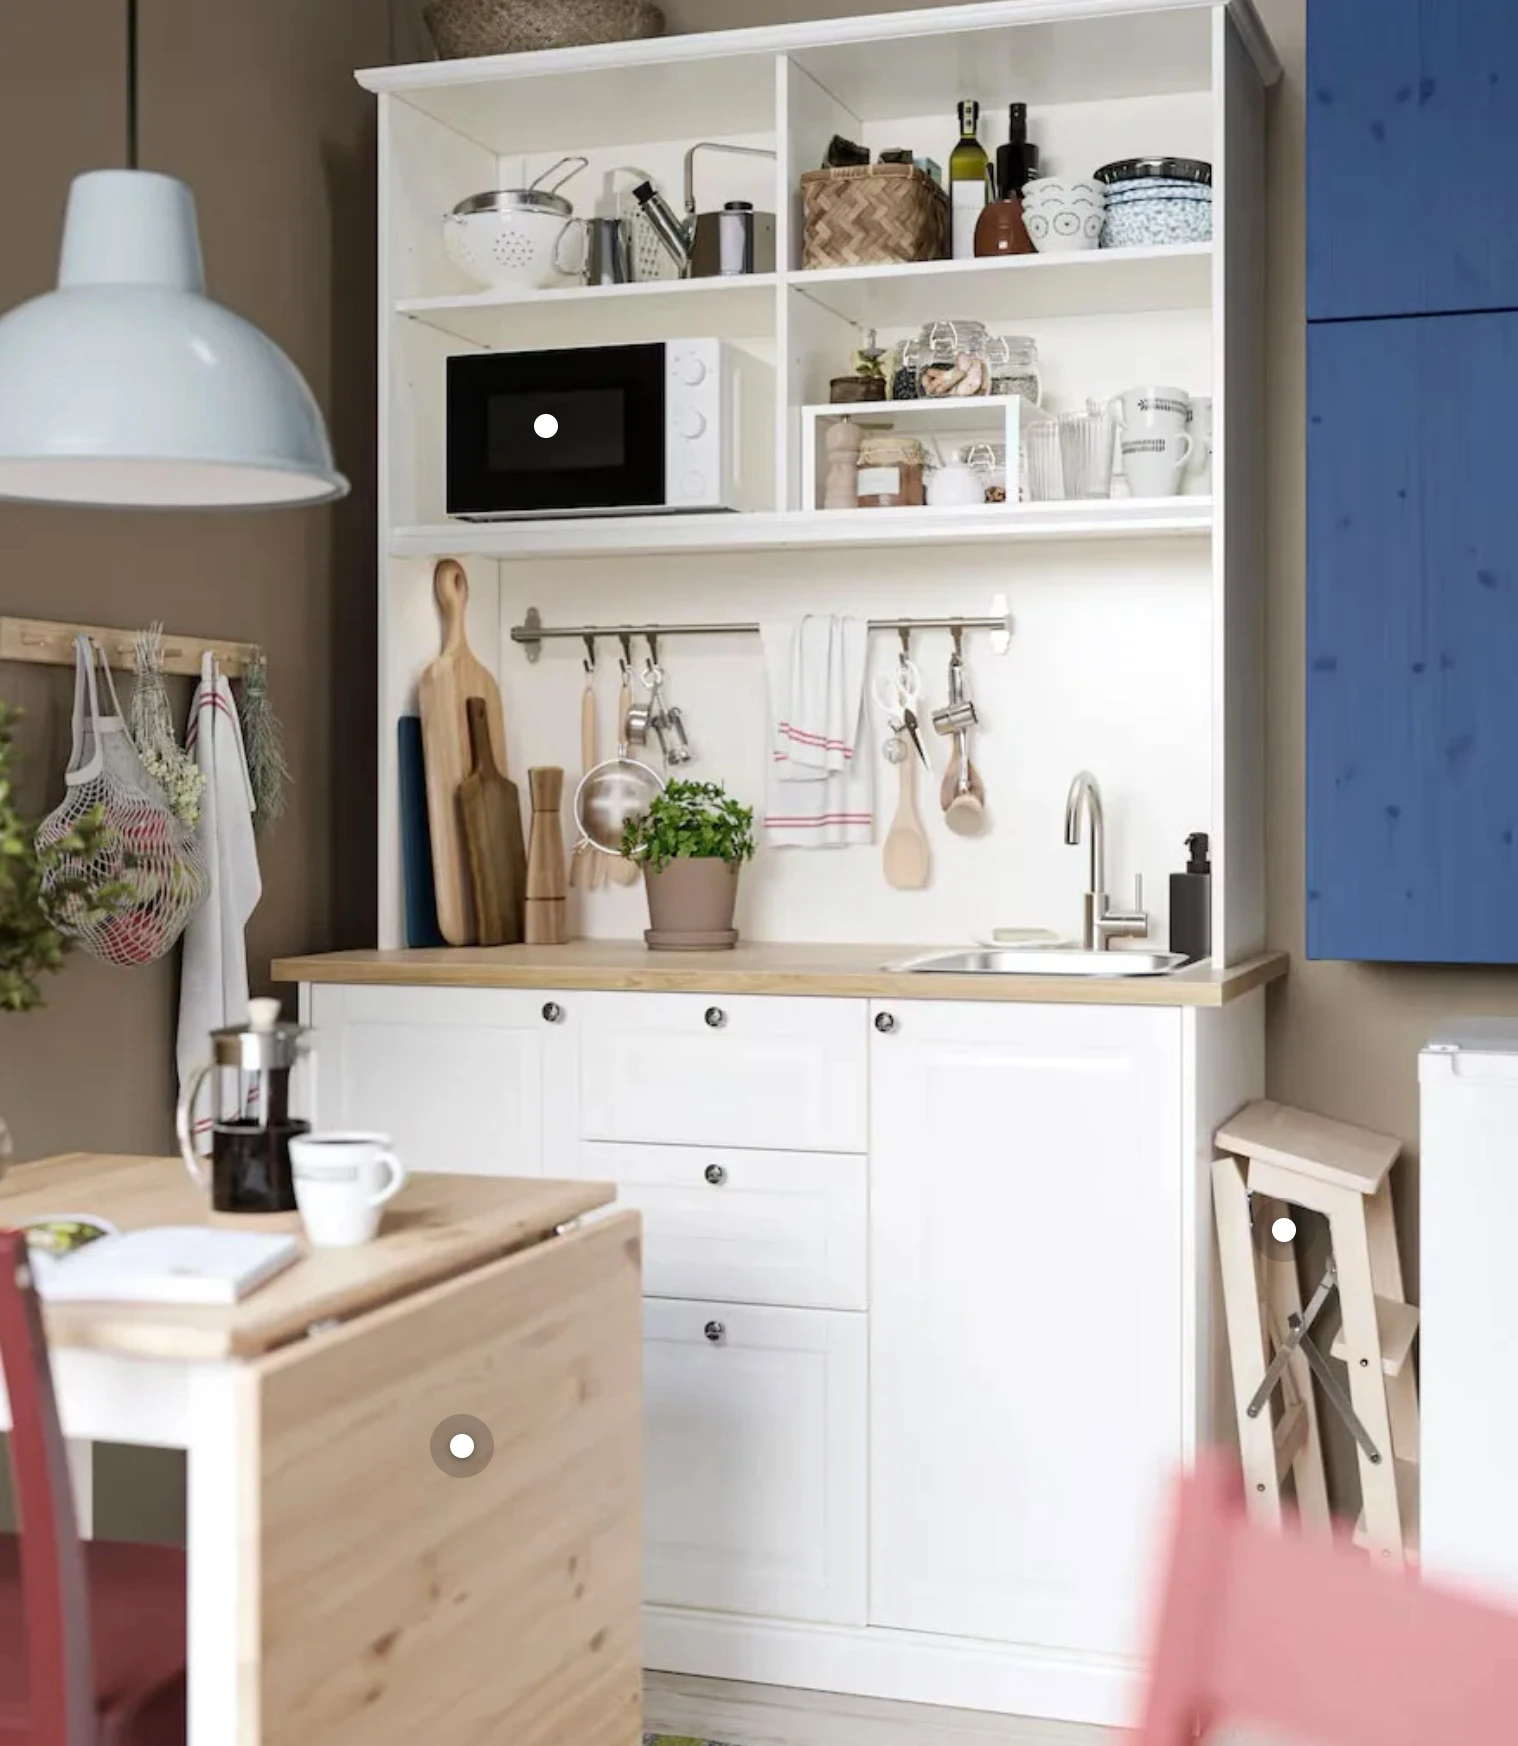
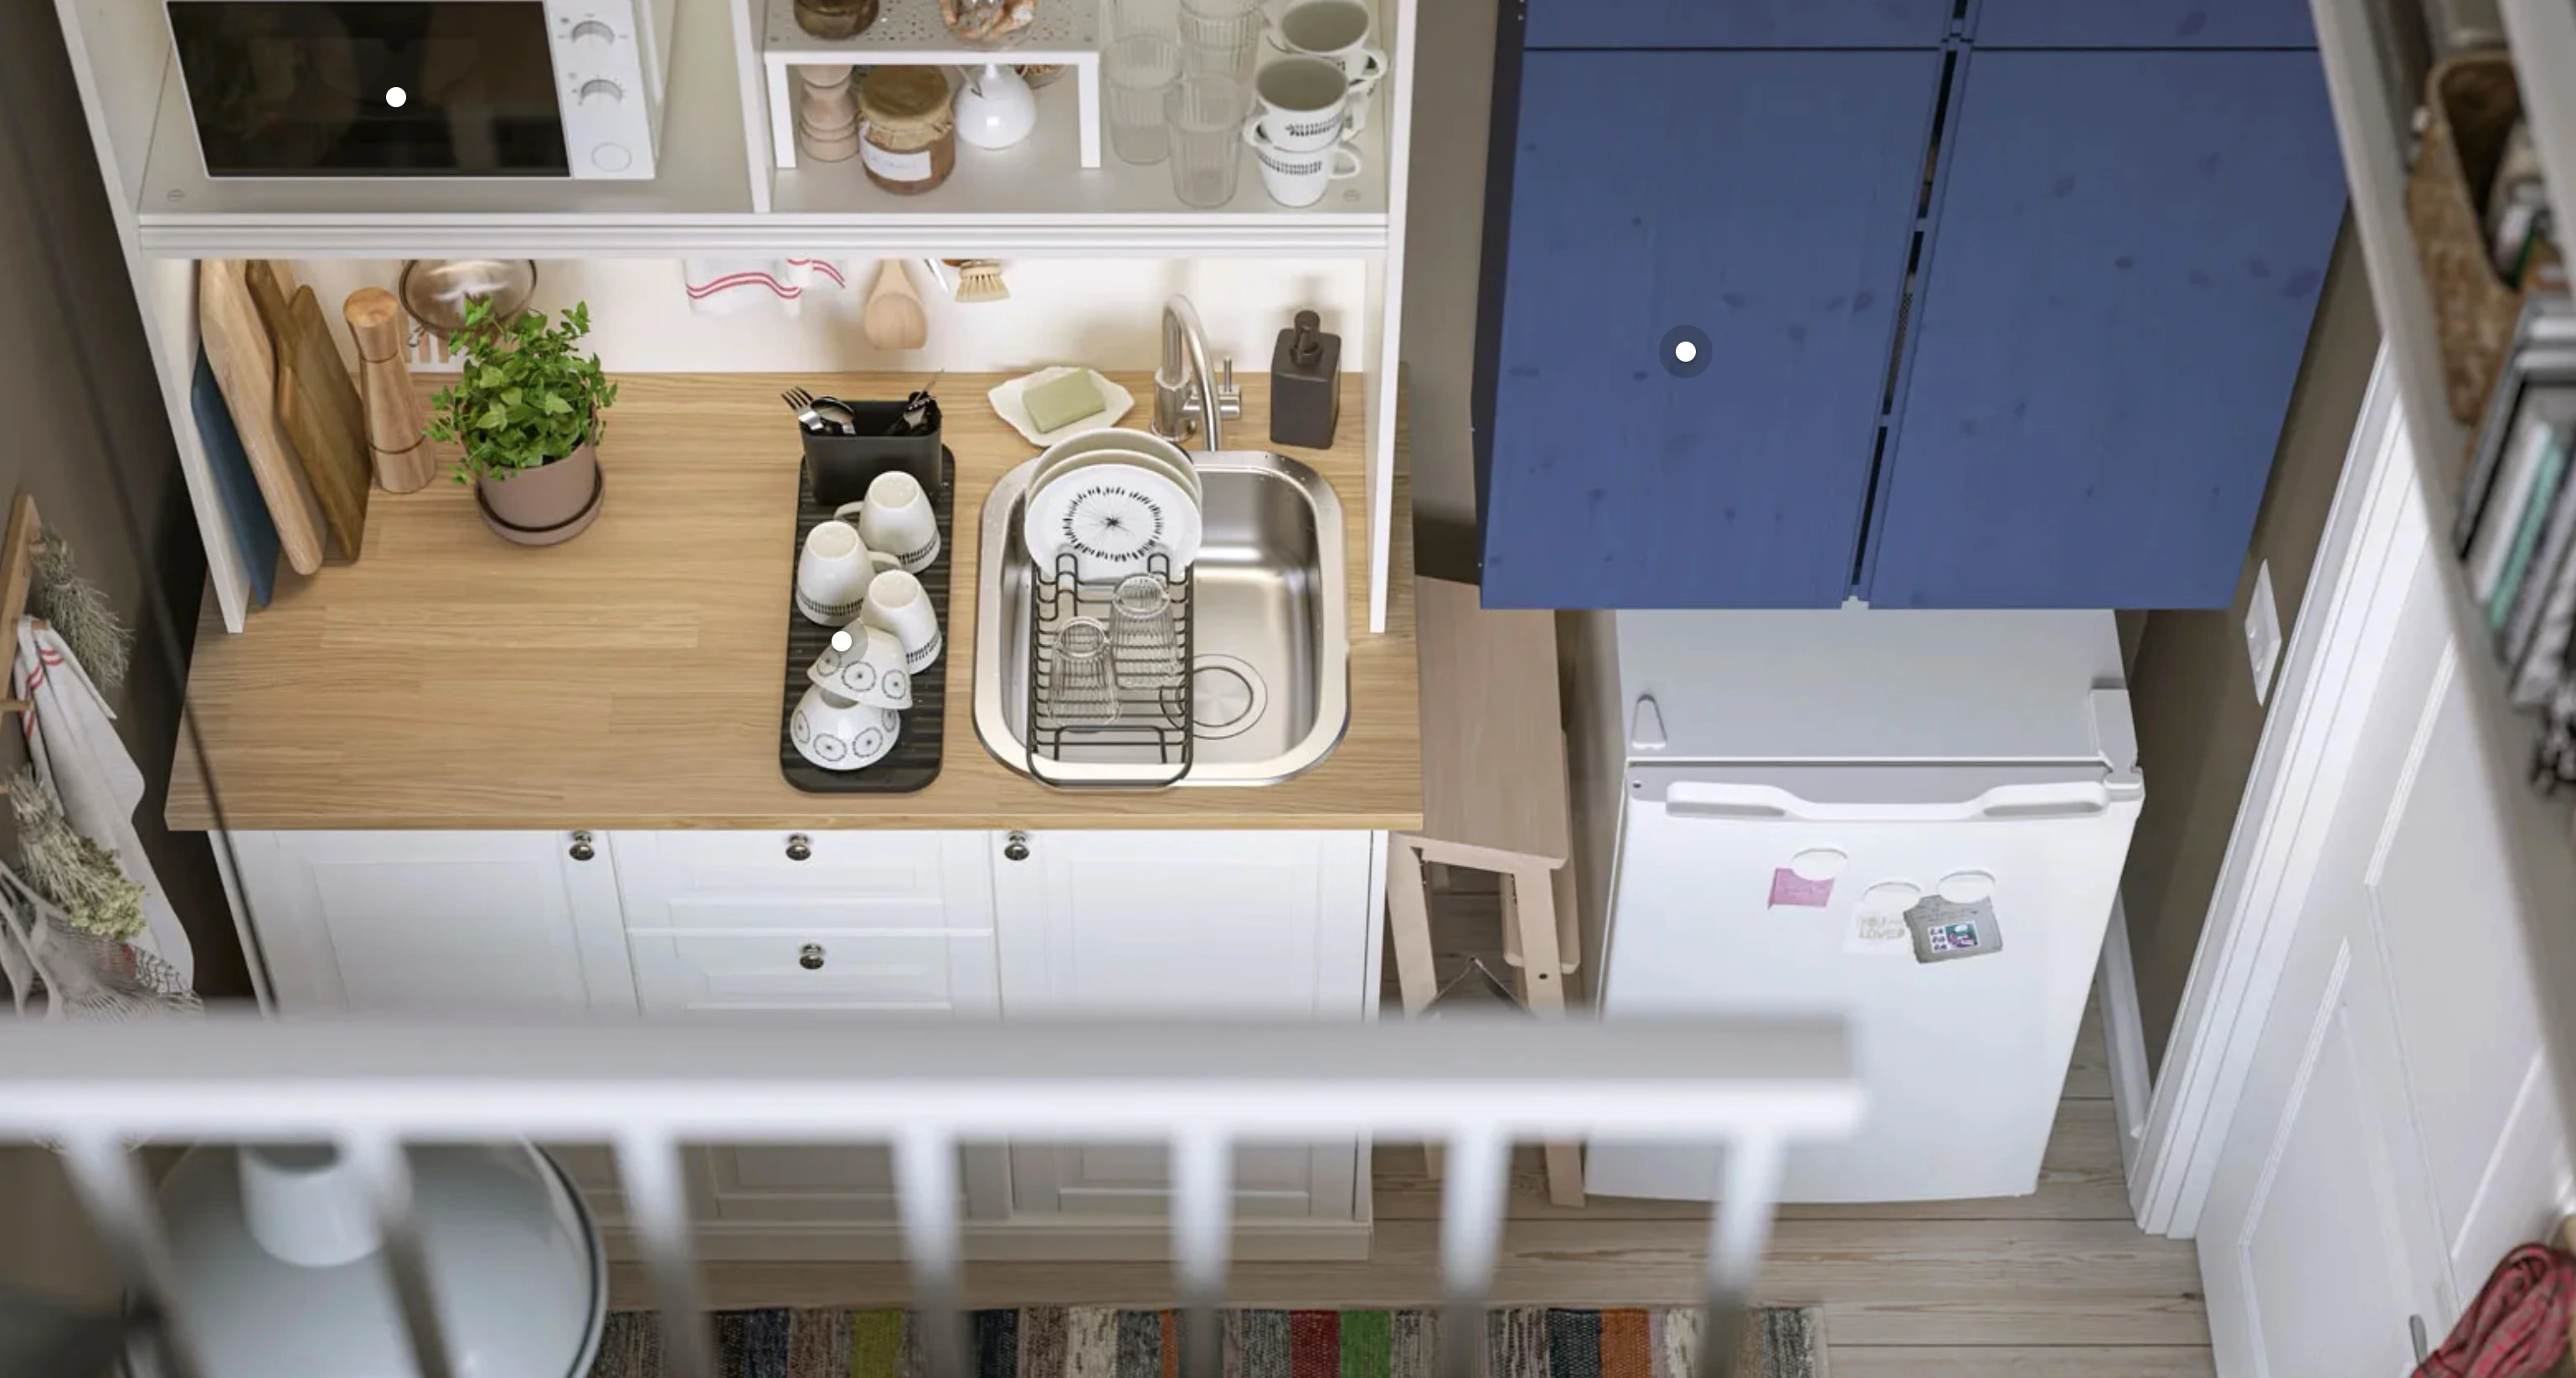
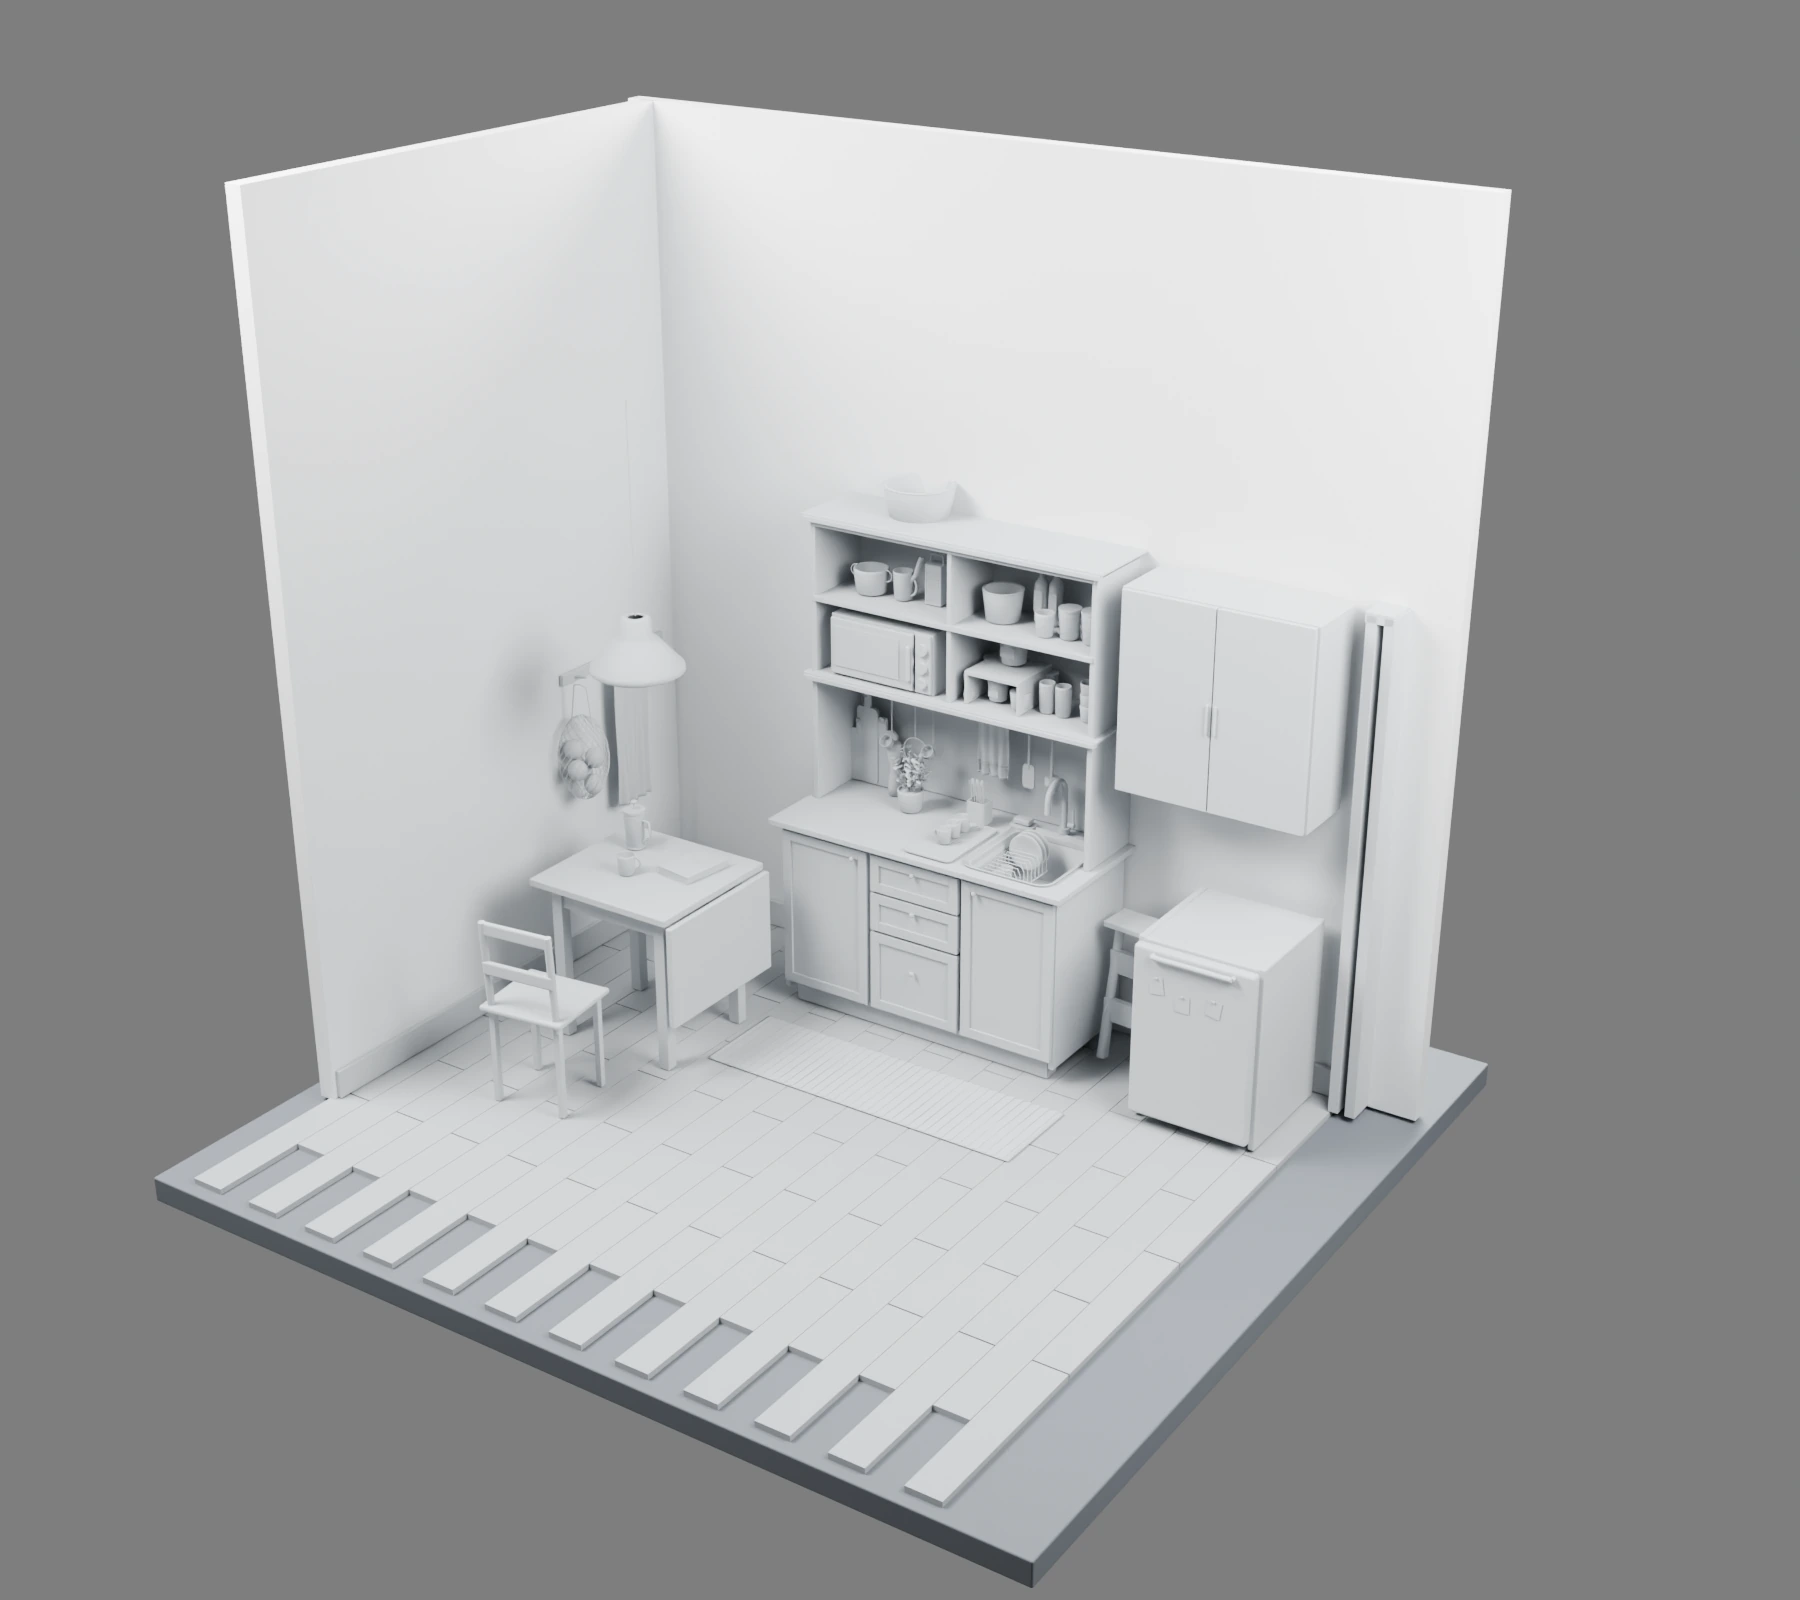
Astra 建模以主柜和台面来估计尺度,先统一固定家具(主柜、蓝壁柜、微波炉和冰箱),再参考俯视图进行小物件摆放,将砧板、杯盘、瓶罐和挂件等填入其中。厨房场景最终有 73 个独立物体。
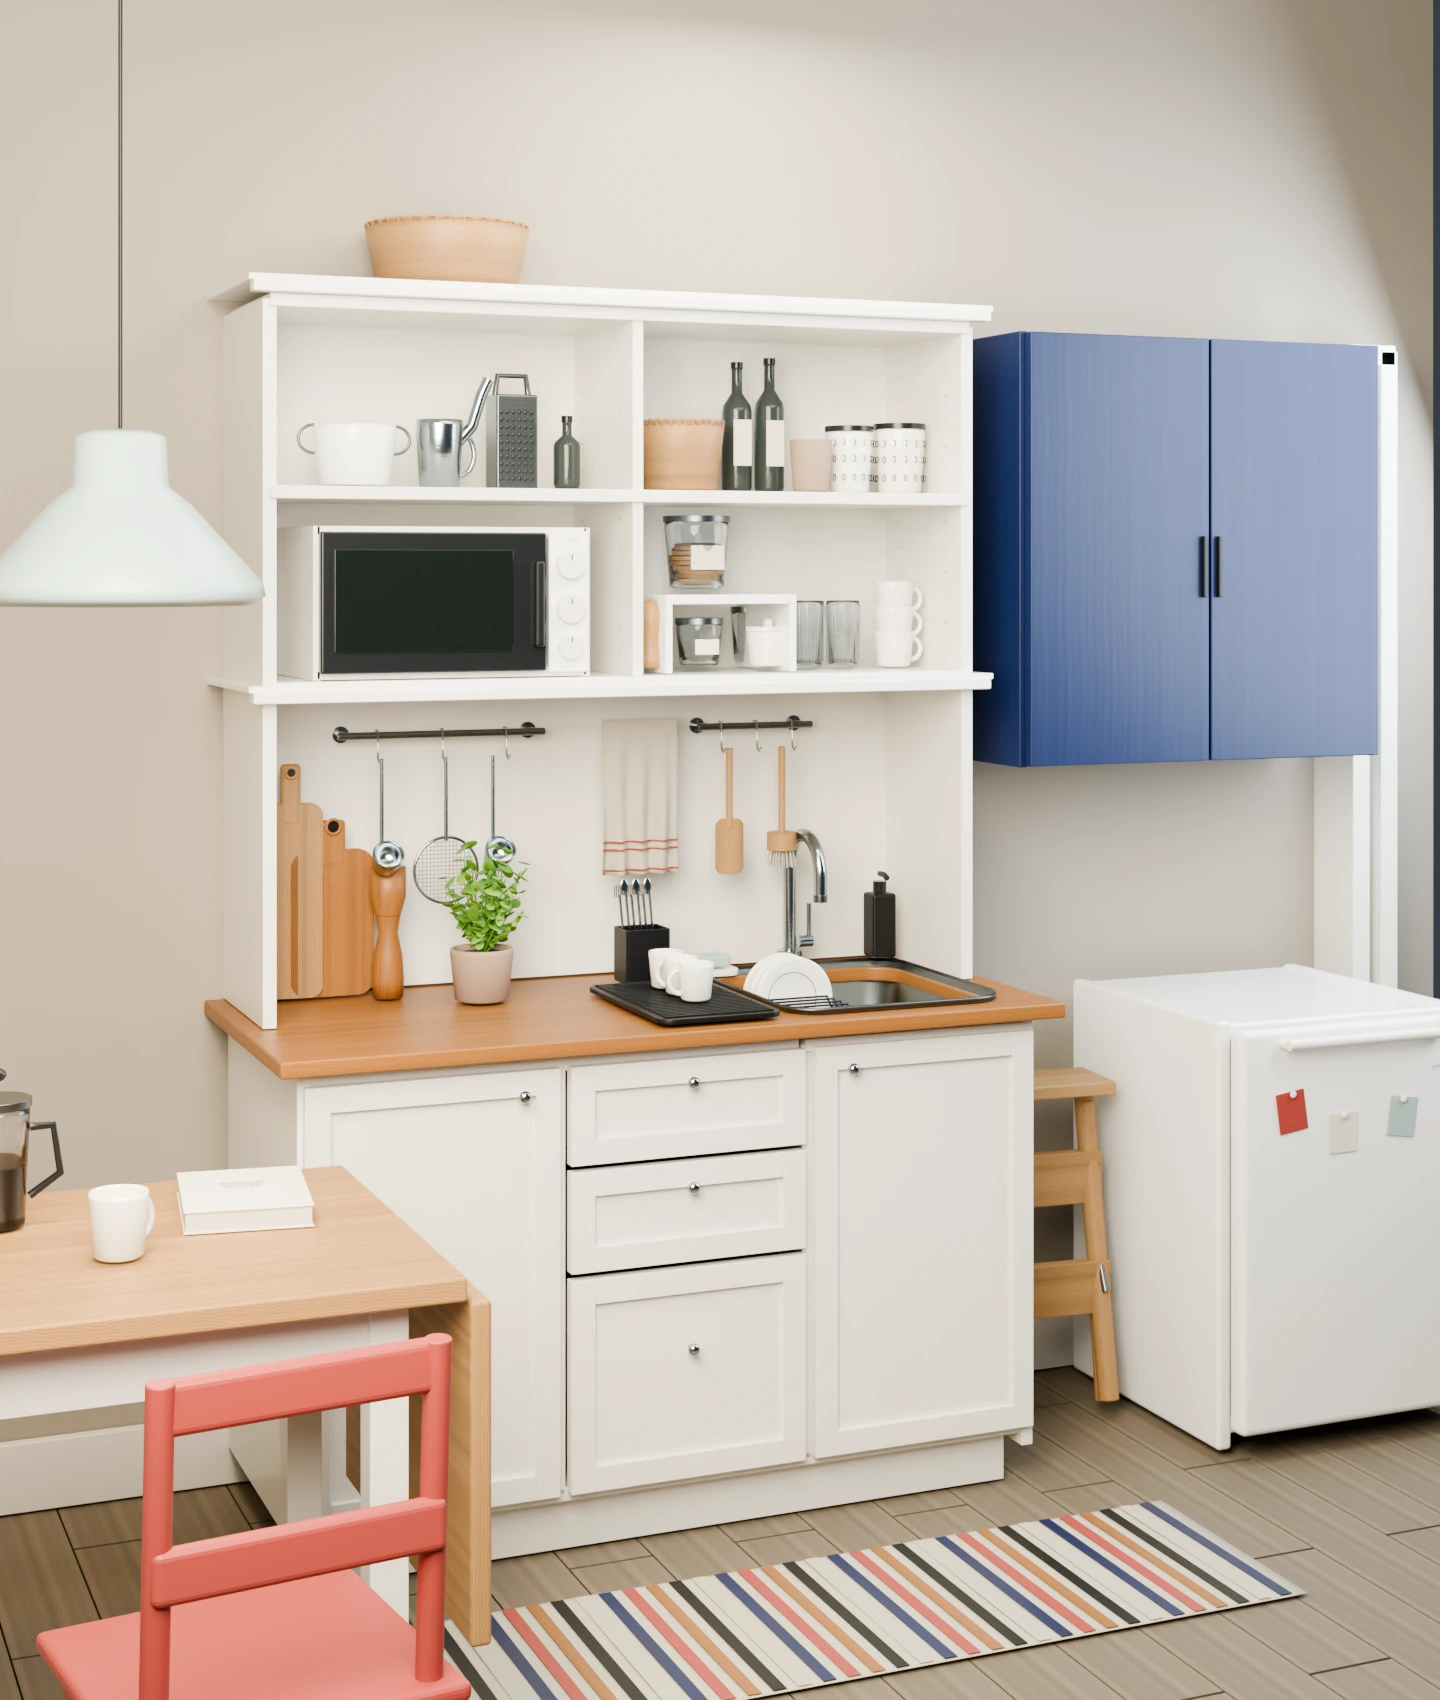
交互集中在大家具上,共 11 个可动关节,包括柜门、抽屉和微波炉等活动部件。
工作区
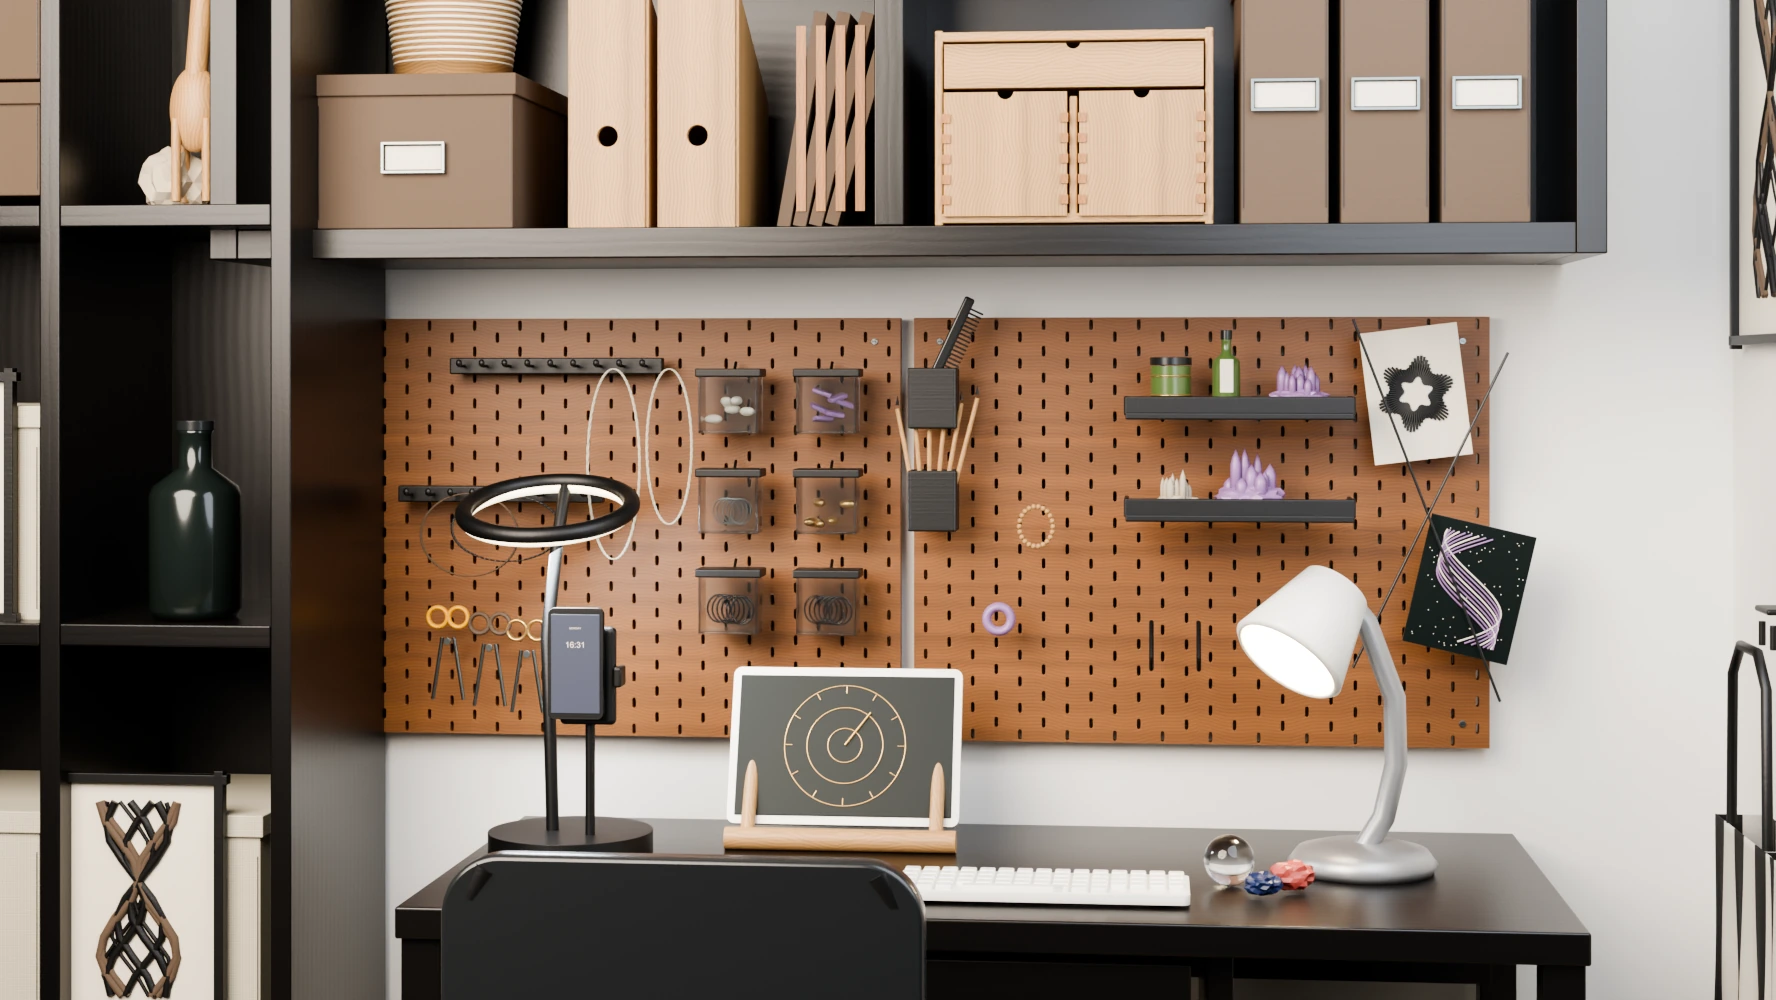
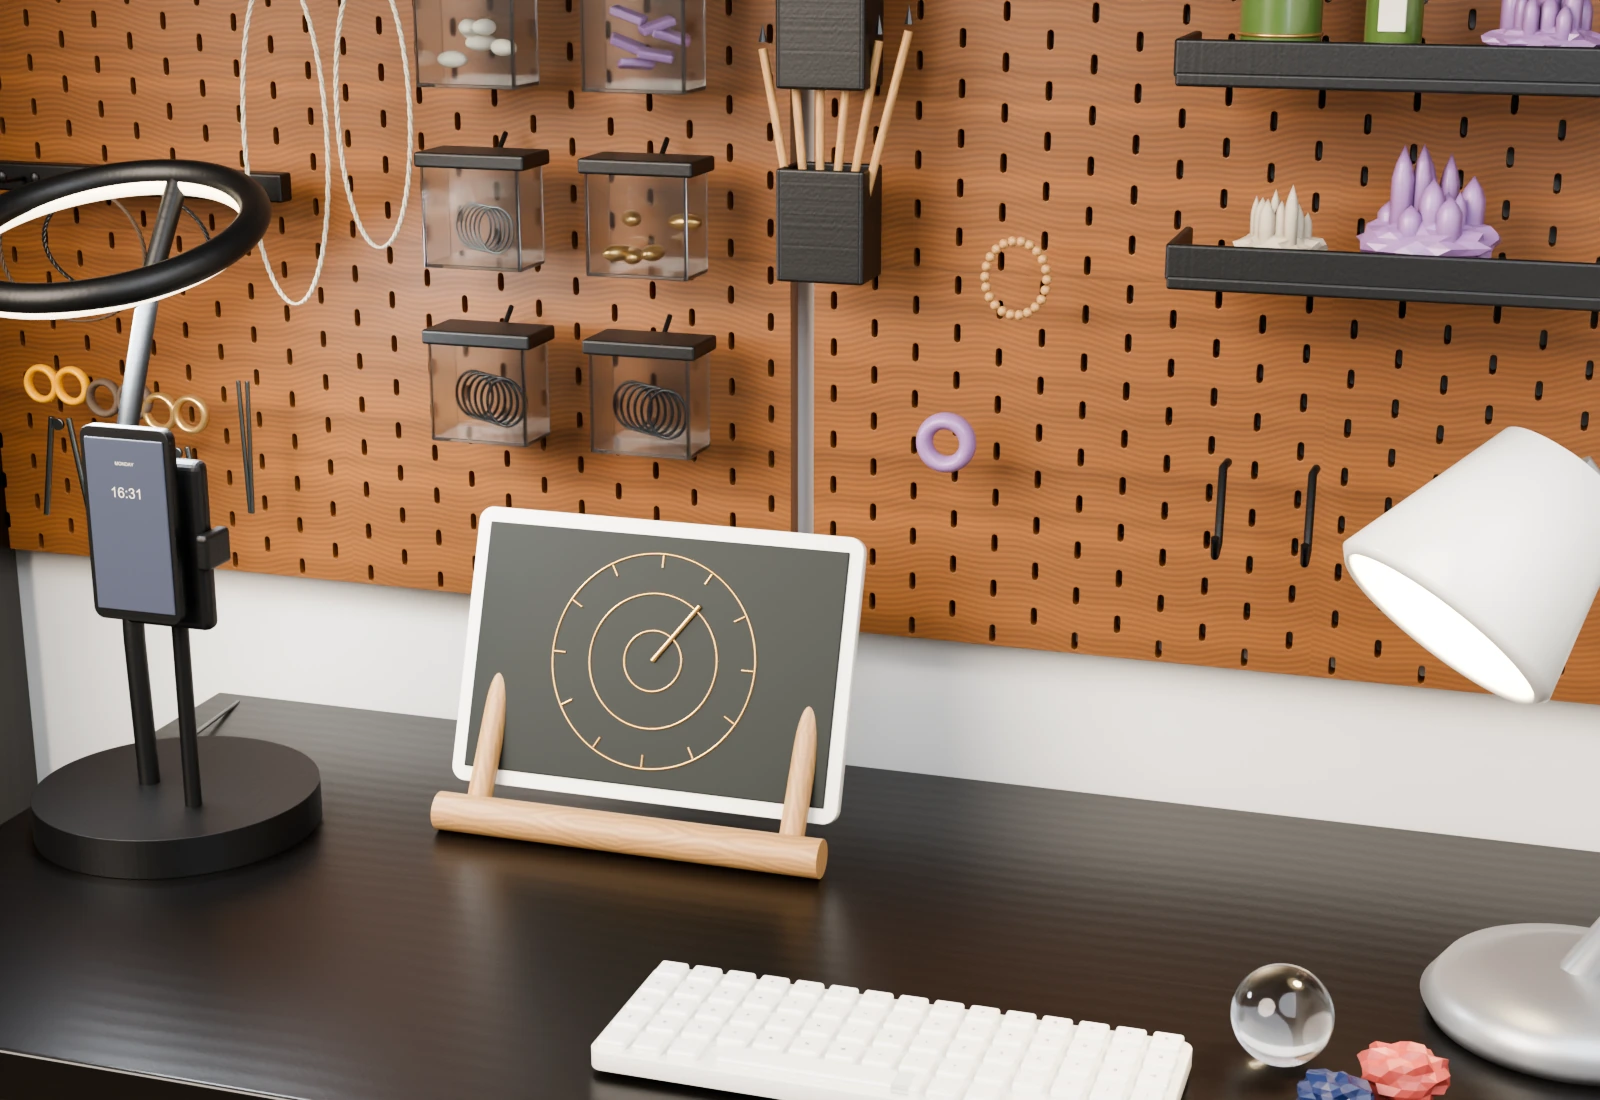
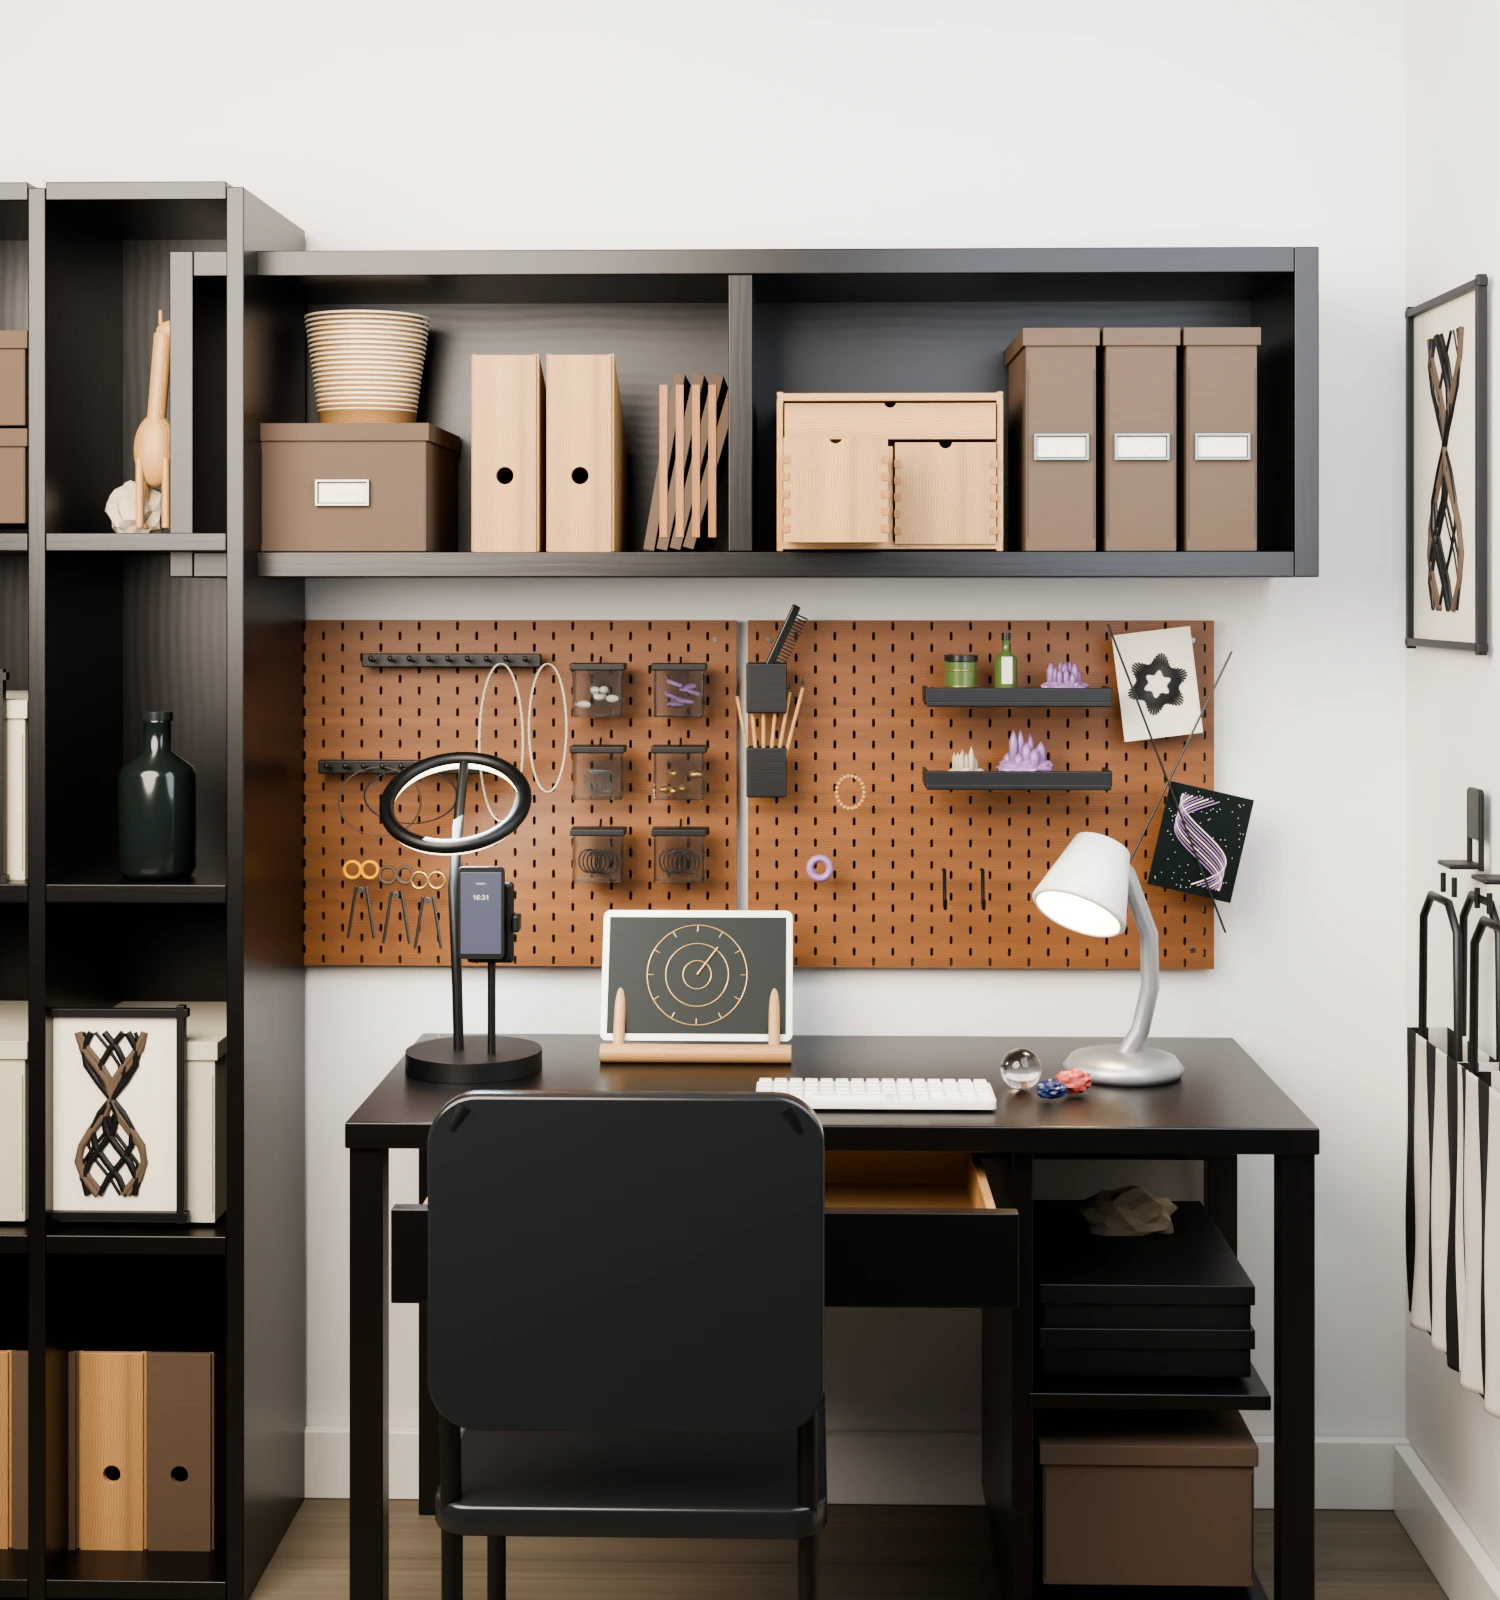
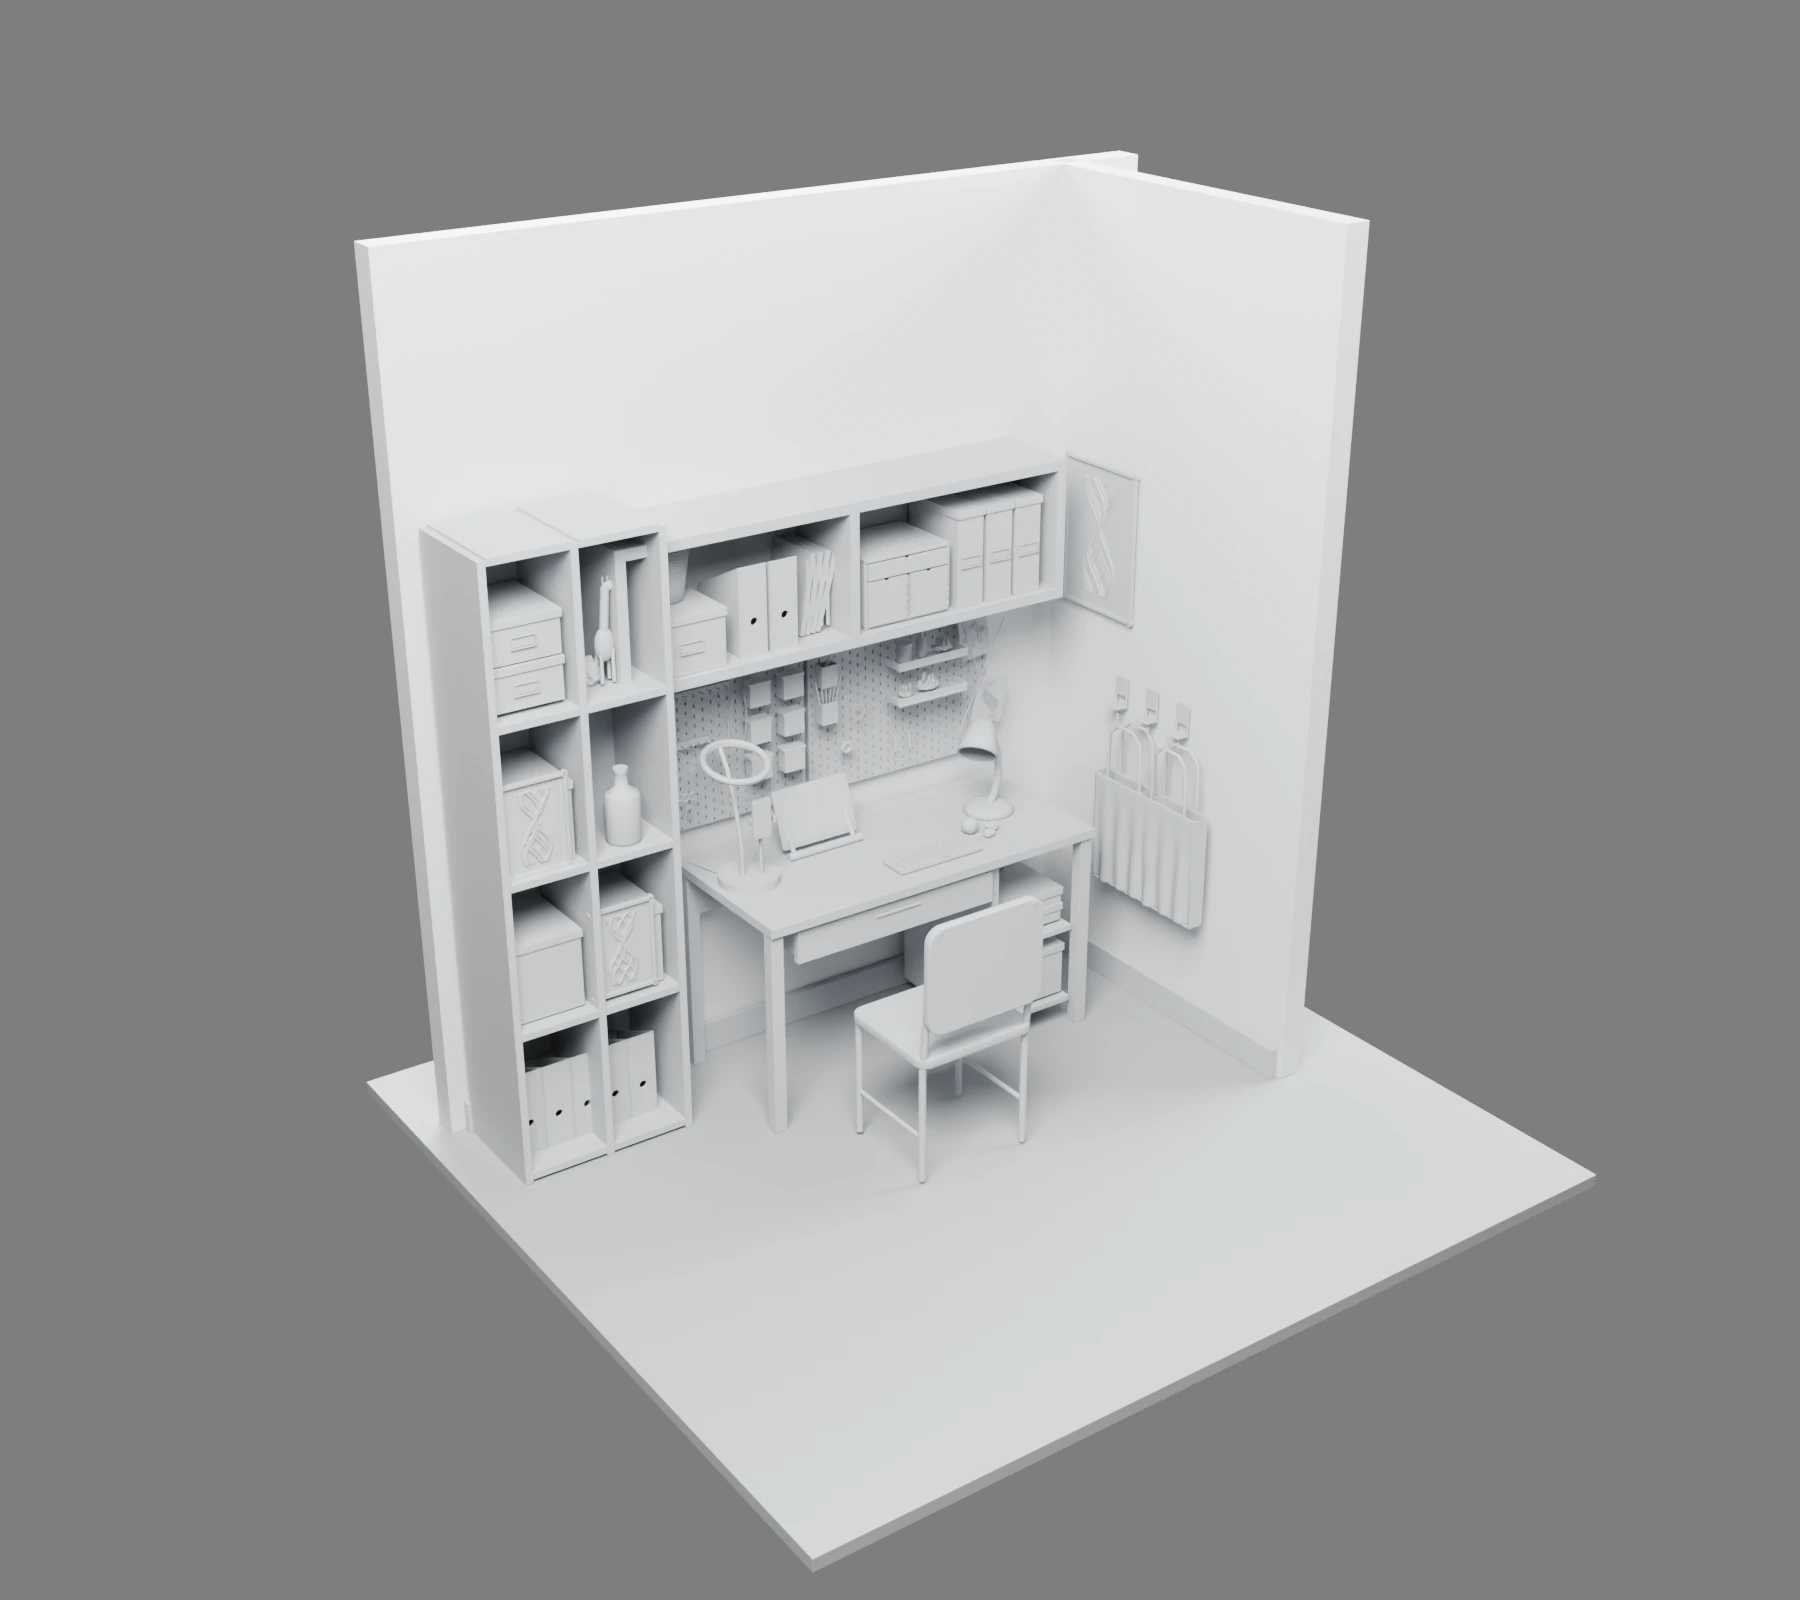
工作区场景只给了一张参考图片,场景中塞满了各种小物件:洞洞板、透明挂盒、剪刀、线圈、矿石、两盏灯,以及桌上的手机和平板。部分内容被遮挡,桌椅也没有全部拍进来。
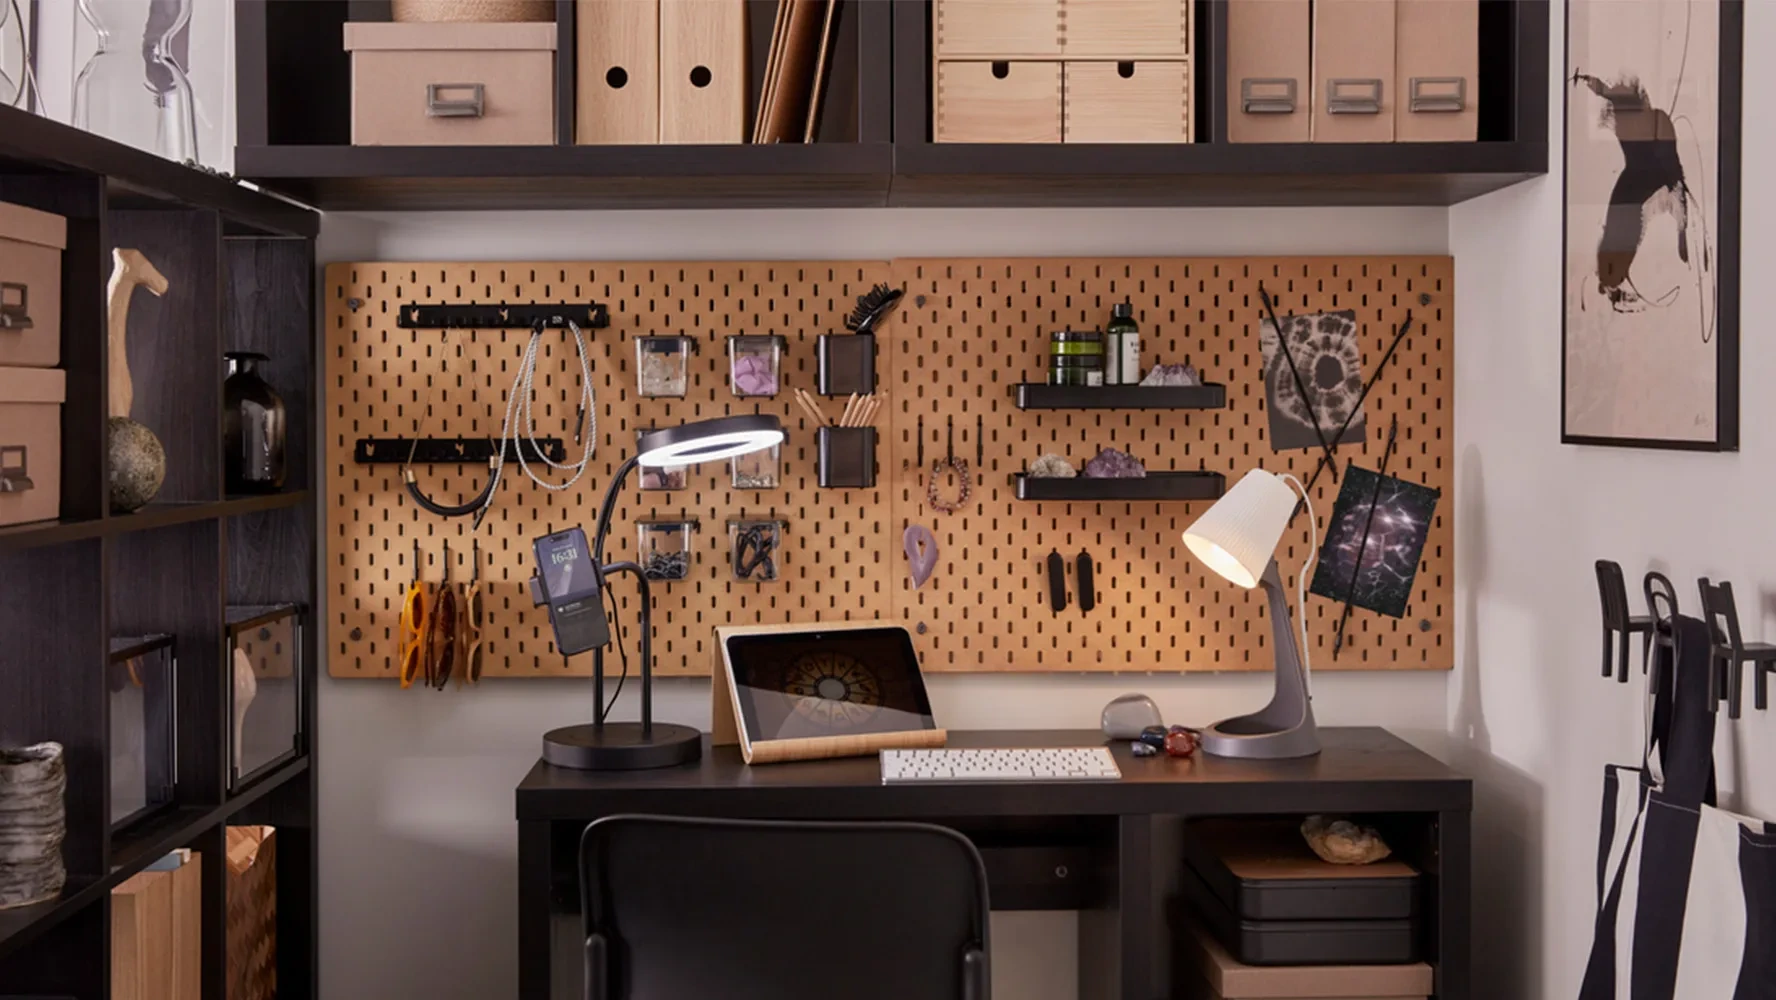
Astra 建模过程先定位桌面、洞洞板和柜架,再补入各处物件。照片外的桌腿、椅子和下层空间也进行补全。
如何从物体到场景
在我要求先安排布局、再渲染比对的基础上,Astra 将任务组织为:
用物体规格表管理家具与道具,把每件物品自身的几何、材质和活动结构,与它在场景里的位置分开记录。
在此基础上,安排了三层工作:
- 先定大关系。 用主要家具估计尺度,确定墙面、桌面和柜体的位置;多张图里出现的同一处空间,需要统一起来。
- 再填入独立物体。 依次补上器具、摆件和挂件,为遮挡部分建立完整形状,并将具体交互分配到主要物体上。
- 检查物体之间的关系。 和参考图片渲染比对时,进一步选择了整体、近景和交互视角,还用几何检查处理穿插、开口和支撑位置。
下一步
目前的流程尚且粗糙,不论是输入本身、流程设计、验收标准,还是与现有 3D vision、AIG3D 的融合,都可以并值得继续探索和深挖。
但另一方面,我们也应该重新思考那些我们习以为常的体系,哪些只是知识,哪些才是智能?而哪些又是「迫不得已」的拙劣手法?